李未可科技发布自研多模态大模型WAKE-AI 三大优化升级AI眼镜交互体验
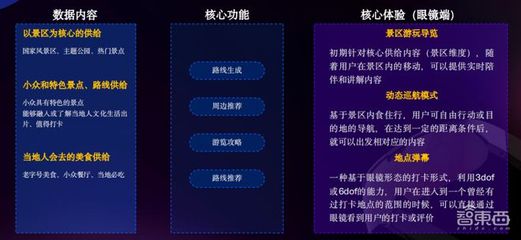
在2024年GenAICon大会上,李未可科技(可古科技)正式发布了自研的多模态大模型WAKE-AI,并宣布通过三大核心优化,显著提升了AI眼镜的交互体验。这一创新成果标志着AI眼镜从“功能机”向“智能体”的跨越,为可穿戴设备领域注入了新的活力。
背景:AI眼镜的交互瓶颈
AI眼镜作为下一代计算平台的候选者,长期受限于交互的自然性与效率。传统语音助手往往依赖云端大模型,存在响应延迟、多模态理解不足、续航短等问题。李未可科技创始人茹忆在演讲中指出:“AI眼镜的核心挑战在于如何在有限算力下实现流畅、自然、持久的智能交互。”为此,团队自研了WAKE-AI大模型,从架构到算法进行全栈优化。
WAKE-AI的三大优化:端云协同、多模态融合、低功耗设计
- 端云协同推理:大幅降低延迟
WAKE-AI采用端侧轻量化模型与云端大模型协同的架构。端侧模型负责实时唤醒、语音识别和基础意图理解,云端模型处理复杂任务。通过动态分流机制,常见指令在端侧闭环,响应时间从秒级降至毫秒级。例如,在嘈杂环境中唤醒眼镜,端侧模型能精准拾音,避免误触发。茹忆演示了“导航回家”指令:端侧迅速识别并触发导航,同时云端同步路况信息,整体延迟不到0.5秒。
- 多模态深度融合:自然交互再升级
WAKE-AI不再局限于语音,而是融合视觉、语音、传感器数据(如头部动作、环境光)。通过跨模态对齐技术,模型能理解用户的复合意图。例如,用户看着某家餐厅并问“营业吗?”,模型即可结合视线方向与语音,直接回答餐厅信息。另一个场景中,用户做“滑动”手势并说“拍照”,眼镜自动拍摄并分类存储。李未可科技称,多模态融合让交互从“命令式”转向“对话式”,理解准确率提升30%以上。
- 低功耗设计:续航倍增
针对AI眼镜的功耗痛点,WAKE-AI引入动态电压频率调整(DVFS)和稀疏化建模技术。根据任务复杂度自动调节算力分配,并将模型参数稀疏化,减少冗余计算。实测表明,连续语音交互场景下功耗降低40%,本地视频处理功耗降低25%。配合低功耗芯片,AI眼镜可连续使用8小时以上,待机达72小时。
用户体验升级:从听到、看到到理解
三大优化的结合,使AI眼镜实现了“能听、能看、能懂”的升级。在会议场景中,WAKE-AI能实时转录对话并区分发言人;在旅行时,眼镜可识别地标并讲述历史;运动时,抬头即可查看心率与配速。李未可科技还开放了WAKE-AI的API,开发者可调用多模态能力创建专属技能。
AI眼镜迎来“WAKE”时刻
茹忆表示:“WAKE-AI的命名寓意‘唤醒’,我们希望它是一个知识渊博、有求必应的外脑。”目前,WAKE-AI已应用于李未可科技新一代AI眼镜,并将通过OTA陆续推送。在GenAICon 2024展台,观众可以体验其多模态交互。随着大模型在端侧的落地,AI眼镜正从概念走向实用,而李未可科技通过软硬一体自研,为行业提供了可借鉴的路径。团队将坚定地向“让智能无感融入生活”迈进。